Банк заданий
ЕГЭ по информатике Задание №27 Анализ данных
Бесплатно готовься к экзаменам
на проверенных материалах ФИПИ
Найдите нужные задания по ЕГЭ, Информатика, номеру или теме. Любое задание можно открыть в каталоге или решить в тренажёре.
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике. Каждая звезда обязательно принадлежит только одному из кластеров.
Истинный центр кластера, или центроид, – это одна из звёзд на графике, сумма расстояний от которой до всех остальных звёзд кластера минимальна. Под расстоянием понимается расстояние Евклида между двумя точками и на плоскости, которое вычисляется по формуле:
.
В файле A хранятся данные о звёздах двух кластеров. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата (в условных единицах). Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах трёх кластеров. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/18050_27A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/18050_27B.txt
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике, лежащий внутри прямоугольника высотой и шириной . Каждая звезда обязательно принадлежит только одному из кластеров.
Под расстоянием между двумя кластерами понимается минимальное расстояние между двумя звёздами этих кластеров, а расстояние между двумя точками и на плоскости вычисляется по формуле Евклида:
.
В файле A хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах, которые представлены вещественными числами. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах пяти кластеров, где , для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите два кластера, расстояние между которыми минимально, и затем вычислите два числа: – сумму координат абсцисс точек, образующих минимальное расстояние между этими кластерами, и – сумму координат ординат этих точек.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
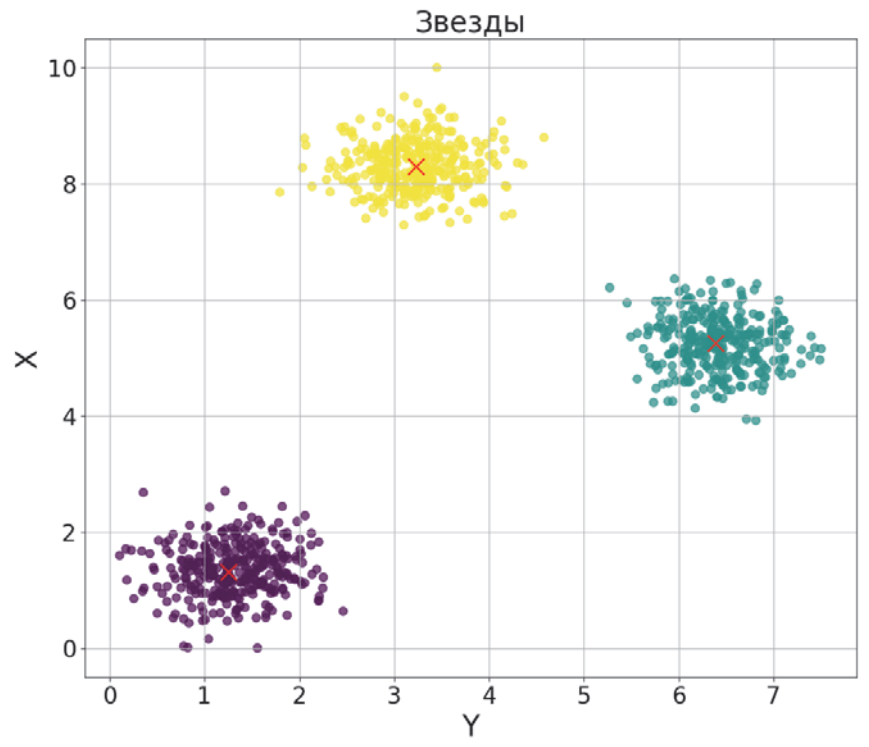
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/18031_27A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/18031_27B.txt
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике, лежащий внутри прямоугольника высотой и шириной . Каждая звезда обязательно принадлежит только одному из кластеров.
Истинный центр кластера, или центроид, – это одна из звёзд на графике, сумма расстояний от которой до всех остальных звёзд кластера минимальна. Под расстоянием понимается расстояние Евклида между двумя точками и на плоскости, которое вычисляется по формуле:
.
В файле A хранятся данные о звёздах, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах, где , для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите минимальное возможное количество кластеров для соответствующего набора, а также координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
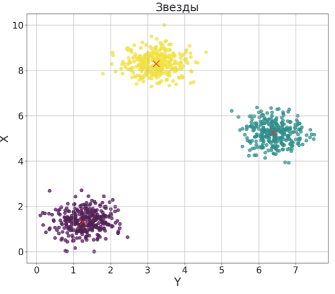
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17917_27_A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17917_27_B.txt
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике, лежащий внутри прямоугольника высотой H и шириной W. Каждая звезда обязательно принадлежит только одному из кластеров.
Истинный центр кластера, или центроид, – это одна из звёзд на графике, сумма расстояний от которой до всех остальных звёзд кластера минимальна. Под расстоянием понимается расстояние Евклида между двумя точками и на плоскости, которое вычисляется по формуле:
.
В файле A хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах пяти кластеров, где , для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
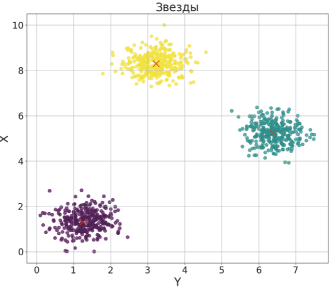
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17916_27_A.txt
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17916_27_B.txt
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике, лежащий внутри прямоугольника высотой и шириной . Каждая звезда обязательно принадлежит только одному из кластеров.
Истинный центр кластера, или центроид, – это одна из звёзд на графике, сумма расстояний от которой до всех остальных звёзд кластера минимальна. Под расстоянием понимается расстояние Евклида между двумя точками и на плоскости, которое вычисляется по формуле:
.
В файле A хранятся данные о звёздах трёх кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах четырёх кластеров, где , для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
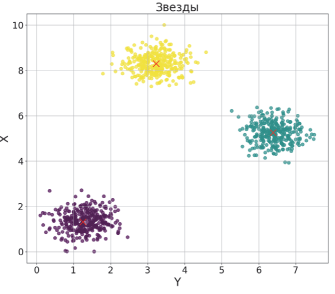
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17915_27_A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17915_27_B.txt
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям.
Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости и вычисляется по формуле:
.
В файле A хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах трёх кластеров, где , для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
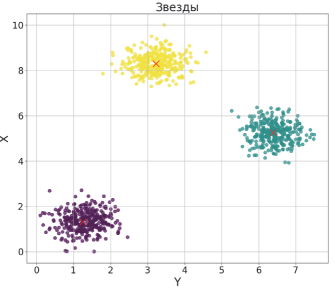
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17882_27_A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17882_27_B.txt
Учёный решил провести кластеризацию некоторого множества звёзд по их расположению на карте звёздного неба. Кластер звёзд – это набор звёзд (точек) на графике, лежащий внутри круга радиусом . Каждая звезда обязательно принадлежит только одному из кластеров.
Истинный центр кластера, или центроид, – это одна из звёзд на графике, сумма расстояний от которой до всех остальных звёзд кластера минимальна. Под расстоянием понимается расстояние Евклида между двумя точками на плоскости и вычисляется по формуле:
.
В файле A хранятся данные о звёздах двух кластеров, где для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Значения даны в условных единицах, которые представлены вещественными числами. Известно, что количество звёзд не превышает 1000.
В файле B хранятся данные о звёздах трёх кластеров, где для каждого кластера. Известно, что количество звёзд не превышает 10000. Структура хранения информации о звездах в файле B аналогична файлу А.
Для каждого файла определите координаты центра каждого кластера, затем вычислите два числа: – среднее арифметическое абсцисс центров кластеров, и – среднее арифметическое ординат центров кластеров.
В ответе запишите четыре числа: в первой строке сначала целую часть произведения , затем целую часть произведения для файла А, во второй строке – аналогичные данные для файла B.
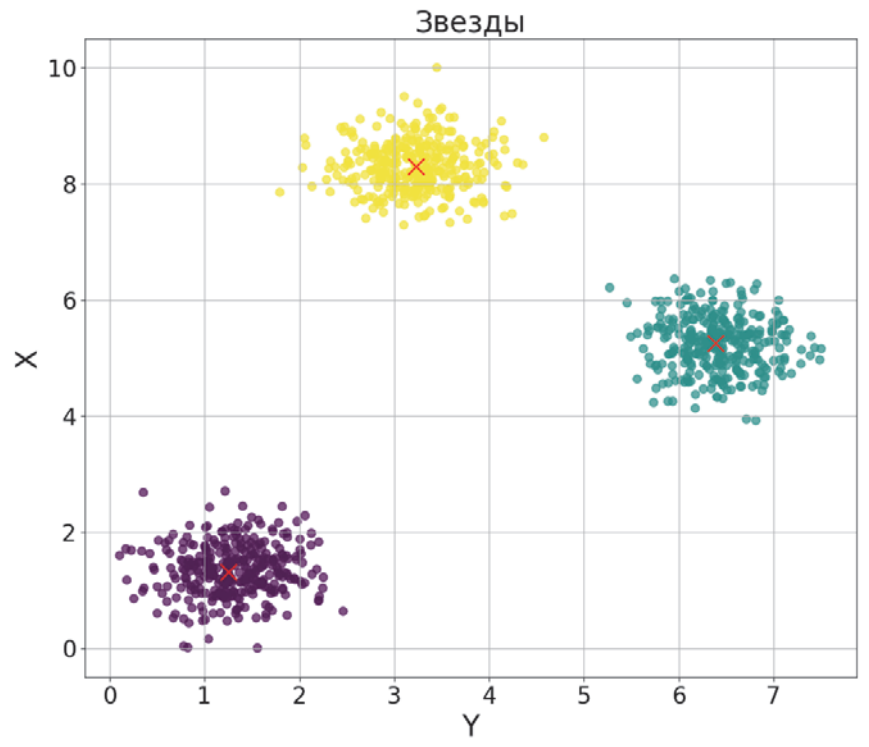
Возможные данные одного из файлов проиллюстрированы графиком.
Внимание! График приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию.
Для выполнения задания используйте данные из прилагаемых файлов.
Файл А к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17834_27_A.txt
Файл B к заданию: https://storage.yandexcloud.net/100points-bank/informatics-ege/files/17834_27_B.txt
Рассматриваются частицы на плоскости, обладающие следующими характеристиками: декартовы координаты, вектор скорости, масса, а также признак, характеризующий внутреннее строение частицы, обозначаемый числами от I до VII (в римской системе счисления).
Учёный решил провести кластеризацию частиц по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких, что модуль разности кинетических энергий любых двух частиц каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его частицу, для которой сумма модулей разности кинетических энергий со всеми остальными частицами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В каждой строке текстового файла хранится информация об одной частице: координаты и , проекции вектора скорости и , масса и признак.
Значения даны в одинаковых для всех частиц единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000. Абсолютная величина каждого числового значения не превышает 100.0.
Известно, что все описанные в файле частицы подразделяются ровно на 4 кластера () с для каждого.
Для каждого кластера определите его центр, затем найдите два числа: – наибольшее евклидово расстояние между частицами одного кластера, имеющими признак II, и – максимальное значение кинетической энергии для центра кластера.
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Для справки
Кинетическая энергия частицы массы , обладающей скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трёх частиц:
0,67 –2,14 3,0 –4,0 0,2 V
3,14 7,22 3,2 4,3 0,7 II
1,33 5,56 0,00 5,22 0,456 IV
Для частицы из первой строки примера кинетическая энергия равна 2,5.
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1Wu8Emm12p6d4O1SDRvu2639dE9HWygNK/view?usp=drive_link
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) согласно таблице. Каждый из спектральных классов, в свою очередь, делится на подклассы от 0 до 9 в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, B2). Класс светимости звезды обозначим римскими цифрами от I до VII.
Обозначение | Цвет | Обозначение | Размер |
|---|---|---|---|
O | голубой | I | сверхгигант |
B | бело-голубой | II | яркий гигант |
A | белый | III | гигант |
F | жёлто-белый | IV | субгигант |
G | жёлтый | V | карлик |
K | оранжевый | VI | субкарлик |
M | красный | VII | белый карлик |
В файле хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Далее в той же строке для звёзд классов светимости I–VI указываются спектральный класс, подкласс и класс светимости. Обозначения классов ничем не разделяются. Для звёзд класса светимости VII (Белый карлик) обозначения спектрального класса и подкласса в файле не указываются. Известно, что количество точек не превышает 2000.
Определите координаты центра каждого кластера, затем найдите два числа: – количество желтых карликов, расположенных на расстоянии не более 2,0 от центра кластера, который содержит наибольшее количество желтых карликов, и – расстояние между центрами кластеров.
В ответе запишите два числа: сначала , затем целую часть произведения .
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788 8,32466 G2V
4,289251 6,955186 VII
4,619358 5,524697 B7V
6,91934 20,425391 G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/13dQUI_AUvHzfH-p1Fk-P8ayeVjvkopc9/view
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) согласно таблице. Каждый из спектральных классов, в свою очередь, делится на подклассы от 0 до 9 в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, B2). Класс светимости звезды обозначим римскими цифрами от I до VII.
Обозначение | Цвет | Обозначение | Размер |
|---|---|---|---|
O | голубой | I | сверхгигант |
B | бело-голубой | II | яркий гигант |
A | белый | III | гигант |
F | жёлто-белый | IV | субгигант |
G | жёлтый | V | карлик |
K | оранжевый | VI | субкарлик |
M | красный | VII | белый карлик |
В файле хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Далее в той же строке для звёзд классов светимости I–VI указываются спектральный класс, подкласс и класс светимости. Обозначения классов ничем не разделяются. Для звёзд класса светимости VII (Белый карлик) обозначения спектрального класса и подкласса в файле не указываются. Известно, что количество точек не превышает 2000.
Для файла определите координаты центра каждого кластера, затем найдите два числа: – наибольшее расстояние от белого карлика до центра кластера, к которому он относится, и – суммарное расстояние от центров кластеров до точки с координатами .
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788 8,32466 G2V
4,289251 6,955186 VII
4,619358 5,524697 B7V
6,91934 20,425391 G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/1R5BovAx8NXycp4Q7JTUH6ebOEgQsU0Ij/view
Фрагмент звёздного неба спроецирован на плоскость с декартовой системой координат. Учёный решил провести кластеризацию полученных точек, являющихся изображениями звёзд, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждая звезда помимо координат на плоской карте характеризуется своим спектральным классом и классом светимости. Спектральный класс определяет цвет (который связан с температурой звезды) согласно таблице. Каждый из спектральных классов, в свою очередь, делится на подклассы от 0 до 9 в порядке уменьшения температуры. Обозначение подкласса ставится после обозначения спектрального класса (например, B2). Класс светимости звезды обозначим римскими цифрами от I до VII.
Обозначение | Цвет | Обозначение | Размер |
|---|---|---|---|
O | голубой | I | сверхгигант |
B | бело-голубой | II | яркий гигант |
A | белый | III | гигант |
F | жёлто-белый | IV | субгигант |
G | жёлтый | V | карлик |
K | оранжевый | VI | субкарлик |
M | красный | VII | белый карлик |
В файле хранятся данные о звёздах двух кластеров, где , для каждого кластера. В каждой строке записана информация о расположении на карте одной звезды: сначала координата , затем координата . Далее в той же строке для звёзд классов светимости I–VI указываются спектральный класс, подкласс и класс светимости. Обозначения классов ничем не разделяются. Для звёзд класса светимости VII (Белый карлик) обозначения спектрального класса и подкласса в файле не указываются. Известно, что количество точек не превышает 2000.
Для файла определите координаты центра каждого кластера, затем найдите два числа: – наибольшее расстояние от жёлто-белого субгиганта до центра кластера, которому он относится, и – суммарное расстояние от центров кластеров до точки с координатами .
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Пример организации данных в одном из исходных файлов для случая четырёх звёзд
5,01788 8,32466 G2V
4,289251 6,955186 VII
4,619358 5,524697 B7V
6,91934 20,425391 G2V
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/1F6ZB9THglorCVbrE_oJtF9NZ6sqikh4G/view
Фрагмент подводного мира спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию полученных точек, являющихся местом нахождения морских обитателей, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждое морское существо помимо координат на двухмерной карте глубоководного каньона характеризуется своей зоной обитания (связанной с глубиной и температурой воды) и типом питания. Зоны обитания кодируются латинскими буквами следующим образом. Каждая зона делится на температурные подклассы от 0 до 9 в порядке охлаждения воды. Обозначение подкласса ставится после буквы зоны (например, M5). Тип питания существа обозначается римскими цифрами от I до III.
Обозначение зоны обитания | Зона обитания | Обозначение типа питания | Тип питания |
|---|---|---|---|
E | Мелководье | I | Хищники |
M | Сумеречная зона | II | Планктофаги |
V | Глубинная зона | III | Детритофаги |
В файле хранятся данные о морских обитателях из трёх различных экологических колоний (кластеров). Для каждой колонии параметры разброса координат составляют , . В каждой строке записана информация об одной зафиксированной точке: сначала координата , затем координата , а далее без разделителей указываются характеристики существа (например, E3I или VII). Обозначения характеристик в журнале исследователей записываются слитно. Для существ, относящихся к глубоководным планктофагам (обозначение V-II), температурный подкласс в базе данных не указывается (запись выглядит просто как VII). Известно, что общее количество записей в файле не превышает 2000.
Определите координаты центра каждого кластера, затем найдите два числа: – абсциссу и – ординату центра кластера с наибольшим соотношением количества хищников к количеству жертв (планктофаги и детритофаги).
В ответе запишите два числа: сначала целую часть абсолютного значения произведения , затем целую часть абсолютного значения произведения .
Пример организации данных в одном из исходных файлов для случая четырёх существ
5.01788 8.32466 E3I
4.289251 6.955186 VII
4.619358 5.524697 M5III
6.91934 20.425391 E0II
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/1Ea2Al5_OXNP10MPXi_mfI9i7GFMjRzQh/view
Фрагмент подводного мира спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию полученных точек, являющихся местом нахождения морских обитателей, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждое морское существо помимо координат на двухмерной карте глубоководного каньона характеризуется своей зоной обитания (связанной с глубиной и температурой воды) и типом питания. Зоны обитания кодируются латинскими буквами следующим образом. Каждая зона делится на температурные подклассы от 0 до 9 в порядке охлаждения воды. Обозначение подкласса ставится после буквы зоны (например, M5). Тип питания существа обозначается римскими цифрами от I до III.
Обозначение зоны обитания | Зона обитания | Обозначение типа питания | Тип питания |
|---|---|---|---|
E | Мелководье | I | Хищники |
M | Сумеречная зона | II | Планктофаги |
V | Глубинная зона | III | Детритофаги |
В файле хранятся данные о морских обитателях из трёх различных экологических колоний (кластеров). Для каждой колонии параметры разброса координат составляют , . В каждой строке записана информация об одной зафиксированной точке: сначала координата , затем координата , а далее без разделителей указываются характеристики существа (например, E3I или VII). Обозначения характеристик в журнале исследователей записываются слитно. Для существ, относящихся к глубоководным планктофагам (обозначение V-II), температурный подкласс в базе данных не указывается (запись выглядит просто как VII). Известно, что общее количество записей в файле не превышает 2000.
Определите координаты центра каждого кластера, затем найдите два числа: – расстояние от начала координат до центра того кластера, в котором суммарная координата х всех его обитателей минимальна и – среднее арифметическое всех координат х всех планктофагов, обитающих в глубинной зоне.
В ответе запишите два числа: сначала целую часть произведения , целую часть абсолютного значения произведения .
Пример организации данных в одном из исходных файлов для случая четырёх существ
5.01788 8.32466 E3I
4.289251 6.955186 VII
4.619358 5.524697 M5III
6.91934 20.425391 E0II
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/12VEJjZlMV1Y7pFVJ7X2sbCG8HVFcfKTe/view
Лесной массив спроецирован на плоскость с декартовой системой координат. Лесничий решил провести кластеризацию полученных точек, являющихся местом произрастания деревьев, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждое дерево помимо координат на двухмерной карте лесничества характеризуется своей породой (хвойные или лиственные), возрастной категорией (от 0 до 9 лет, где возраст кодируется цифрой), типом древесины и прогнозируемым объемом получаемой древесины в килограммах. Породы деревьев кодируются латинскими буквами следующим образом. Каждая порода делится на возрастные категории от 0 до 9 в порядке увеличения возраста дерева. Обозначение категории ставится после буквы породы (например, C5). Тип древесины обозначается римскими цифрами от I до III.
Обозначение породы дерева | Порода дерева | Обозначение типа древесины | Тип древесины |
|---|---|---|---|
C | Хвойные | I | Строительная |
D | Лиственные | II | Тарная |
B | Березовые | III | Топливная |
Каждое дерево также имеет числовую характеристику — массу древесины в килограммах (целое число), которая записывается сразу после типа древесины. Для особо ценных березовых деревьев строительного типа (обозначение B-I) возрастная категория в базе данных не указывается, и запись породы выглядит просто как BI, после чего сразу указывается масса древесины (например, BI450). Все характеристики в журнале лесничего записываются слитно.
В файле хранятся данные о деревьях из двух различных лесополос (кластеров). Для каждого кластера параметры разброса координат составляют , . В каждой строке файла записана информация об одной зафиксированной точке: сначала координата , затем координата , а далее без разделителей указываются характеристики дерева (например, C3I250 или BII180). Известно, что общее количество записей в файле не превышает 2000.
Определите координаты центра каждого кластера, затем найдите два числа: – максимальное расстояние от хвойного дерева возрастной категории 5 с топливным типом древесины до центра того кластера, к которому оно относится, и – среднее арифметическое всех координат х всех лиственных деревьев строительного типа.
В ответе запишите два числа: сначала целую часть произведения , целую часть произведения .
Пример организации данных в одном из исходных файлов для случая четырёх существ
5.01788 8.32466 C3I350
4.289251 6.955186 BI500
4.619358 5.524697 D5III120
6.91934 20.425391 C0II220
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/1tcCn4JmuYdVf2XzxDlBHjvdItob8rW-f/view
Лесной массив спроецирован на плоскость с декартовой системой координат. Лесничий решил провести кластеризацию полученных точек, являющихся местом произрастания деревьев, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что точки каждого подмножества лежат внутри прямоугольника со сторонами длиной и , причём эти прямоугольники между собой не пересекаются. Стороны прямоугольников не обязательно параллельны координатным осям. Гарантируется, что такое разбиение существует и единственно для заданных размеров прямоугольников.
Будем называть центром кластера точку этого кластера, сумма расстояний от которой до всех остальных точек кластера минимальна. Для каждого кластера гарантируется единственность его центра. Расстояние между двумя точками на плоскости плоскости и вычисляется по формуле:
.
Каждое дерево помимо координат на двухмерной карте лесничества характеризуется своей породой (хвойные или лиственные), возрастной категорией (от 0 до 9 лет, где возраст кодируется цифрой), типом древесины и прогнозируемым объемом получаемой древесины в килограммах. Породы деревьев кодируются латинскими буквами следующим образом. Каждая порода делится на возрастные категории от 0 до 9 в порядке увеличения возраста дерева. Обозначение категории ставится после буквы породы (например, C5). Тип древесины обозначается римскими цифрами от I до III.
Обозначение породы дерева | Порода дерева | Обозначение типа древесины | Тип древесины |
|---|---|---|---|
C | Хвойные | I | Строительная |
D | Лиственные | II | Тарная |
B | Березовые | III | Топливная |
Каждое дерево также имеет числовую характеристику — массу древесины в килограммах (целое число), которая записывается сразу после типа древесины. Для особо ценных березовых деревьев строительного типа (обозначение B-I) возрастная категория в базе данных не указывается, и запись породы выглядит просто как BI, после чего сразу указывается масса древесины (например, BI450). Все характеристики в журнале лесничего записываются слитно.
В файле хранятся данные о деревьях из двух различных лесополос (кластеров). Для каждого кластера параметры разброса координат составляют , . В каждой строке файла записана информация об одной зафиксированной точке: сначала координата , затем координата , а далее без разделителей указываются характеристики дерева (например, C3I250 или BII180). Известно, что общее количество записей в файле не превышает 2000.
Определите координаты центра каждого кластера, затем найдите два числа: – среднее значение абсцисс всех лиственных деревьев топливного типа в том кластере, где общее количество таких деревьев минимально (но больше нуля), и – расстояние от начала координат до центра того кластера, в котором суммарный прогнозируемый объем получаемой древесины всех его деревьев максимален.
В ответе запишите два числа: сначала целую часть абсолютного значения произведения , затем целую часть абсолютного значения произведения .
Пример организации данных в одном из исходных файлов для случая четырёх существ
5.01788 8.32466 C3I350
4.289251 6.955186 BI500
4.619358 5.524697 D5III120
6.91934 20.425391 C0II220
Внимание! Пример приведён в иллюстративных целях для произвольных значений, не имеющих отношения к заданию. Для выполнения задания используйте данные из прилагаемых файлов.
Файл к заданию: https://drive.google.com/file/d/1HRV9O-2Rz5FR76n2-lZbkkVQaDa1qZwP/view
Рассматриваются частицы на плоскости, обладающие следующими характеристиками: декартовы координаты и , вектор скорости и , масса , а также количество выездов (среднее число зафиксированных событий).
Ученый решил провести кластеризацию частиц по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух частиц каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его частицу, для которой сумма модулей разности кинетических энергий со всеми остальными частицами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В каждой строке текстового файла хранится информация об одной частице: координаты и , проекции вектора скорости и , масса и количество выездов .
Значения даны в одинаковых для всех частиц единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000. Абсолютная величина каждого числового значения не превышает 100.0.
Известно, что все описанные в файле частицы подразделяются ровно на 3 кластера () с для каждого.
Для каждого кластера определите его центр, затем найдите два числа: – среднее арифметическое расстояний между всеми возможными парами центров всех трех кластеров, и – расстояние от начала координат до центра того кластера, в котором разность между максимальным и минимальным количеством выездов из одной частицы максимальна.
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Для справки
Кинетическая энергия частицы массы , обладающей скоростью вычисляется по формуле:
.
Взвешенный путь от центра с координатами до частицы с координатами и количеством выездов вычисляется по формуле
.
Типовой пример организации данных во входном файле
Три строки файла для трёх частиц:
0,67 -2,14 3,0 -4,0 0,2 50
3,14 7,22 3,2 4,3 0,7 10
1,33 5,56 0,0 5,22 0,456 3
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1McSId1lRnUhc6T6oz-G7CjmRntTp5Jq4/view
Рассматриваются частицы на плоскости, обладающие следующими характеристиками: декартовы координаты и , вектор скорости и , масса , а также количество выездов (среднее число зафиксированных событий).
Ученый решил провести кластеризацию частиц по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух частиц каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его частицу, для которой сумма модулей разности кинетических энергий со всеми остальными частицами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В каждой строке текстового файла хранится информация об одной частице: координаты и , проекции вектора скорости и , масса и количество выездов .
Значения даны в одинаковых для всех частиц единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000. Абсолютная величина каждого числового значения не превышает 100.0.
Известно, что все описанные в файле частицы подразделяются ровно на 3 кластера () с для каждого.
Для каждого кластера определите его центр, затем найдите два числа: – максимальное из евклидовых расстояний от начала координат до центра каждого из трех кластеров, и – суммарный взвешенный путь от центра того кластера, в котором находится частица с наименьшей массой , до всех остальных частиц этого же кластера.
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Для справки
Кинетическая энергия частицы массы , обладающей скоростью вычисляется по формуле:
.
Взвешенный путь от центра с координатами до частицы с координатами и количеством выездов вычисляется по формуле
.
Типовой пример организации данных во входном файле
Три строки файла для трёх частиц:
0,67 -2,14 3,0 -4,0 0,2 50
3,14 7,22 3,2 4,3 0,7 10
1,33 5,56 0,0 5,22 0,456 3
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1u0UeraUAc6mmy_nr-u33aw_-pA1usJv3/view
В медицинских исследованиях пациенту в кровь вводят наноботов для точечной борьбы с воспалениями. Спустя время наноботы группируются вокруг очагов болезни. Ученый решил провести кластеризацию наноботов по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух наноботов каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть эпицентром (центром) кластера такого его нанобота, для которого сумма модулей разности кинетических энергий со всеми остальными наноботами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе сканирования датчики фиксируют помехи, вызванные естественным током крови, из-за чего в данных возникают аномалии — одиночные ложные отклики, резко отличающиеся по параметрам и не принадлежащие ни одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одном наноботе: координаты и , проекции вектора скорости и , масса (активность выделения фермента).
Значения даны в одинаковых для всех наноботов единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000.
Известно, что все описанные в файле наноботы (за исключением аномальных) подразделяются ровно на 3 кластера () с для каждого, а также в файле содержится ровно 10 аномальных точек.
Для каждого кластера определите его эпицентр, затем найдите два числа: – отношение суммарной массы всех наноботов кластера с наибольшим количеством элементов к суммарной массе кластера с наименьшим количеством элементов, и – сумму расстояний от каждого из трех найденных эпицентров до начала координат .
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Для справки
Кинетическая энергия нанобота массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех наноботов:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1_S7ZNlbSwUESS0dQOjZNSwPITexAXaRJ/view
В медицинских исследованиях пациенту в кровь вводят наноботов для точечной борьбы с воспалениями. Спустя время наноботы группируются вокруг очагов болезни. Ученый решил провести кластеризацию наноботов по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух наноботов каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть эпицентром (центром) кластера такого его нанобота, для которого сумма модулей разности кинетических энергий со всеми остальными наноботами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе сканирования датчики фиксируют помехи, вызванные естественным током крови, из-за чего в данных возникают аномалии — одиночные ложные отклики, резко отличающиеся по параметрам и не принадлежащие ни одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одном наноботе: координаты и , проекции вектора скорости и , масса (активность выделения фермента).
Значения даны в одинаковых для всех наноботов единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000.
Известно, что все описанные в файле наноботы (за исключением аномальных) подразделяются ровно на 3 кластера () с для каждого, а также в файле содержится ровно 10 аномальных точек.
Для каждого кластера определите его эпицентр, затем найдите два числа: – среднюю массу наноботов в кластере, у которого сумма координат и эпицентра наименьшая, и – максимальное расстояние от эпицентра до точки своего кластера среди всех точек всех трех кластеров.
В ответе запишите два числа: сначала целую часть произведения , затем целую часть произведения .
Для справки
Кинетическая энергия нанобота массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех наноботов:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/19U9at1b3QJ0Z-zCTESyOISH7rMwaKRNo/view
Фрагмент звездного неба спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию звезд по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух звезд каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его звезду, для которой сумма модулей разности кинетических энергий со всеми остальными звездами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе передачи данных датчики фиксируют помехи, из-за чего возникают аномалии — «лишние» точки, не относящиеся ни к одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одной звезде: координаты и , проекции вектора скорости и , а также масса .
Значения даны в одинаковых для всех звезд единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000.
Известно, что все описанные в файле звёзды (за исключением аномальных) подразделяются ровно на 3 кластера () с для каждого, а также в файле содержится ровно 3 аномальные точки. Гарантируется, что во всех кластерах количество точек различно.
Для каждого кластера определите его центр, затем найдите два числа: – число точек наибольшего по количеству точек кластера, находящихся вне круга радиуса 1,5 с центром в центре этого же кластера, и – модуль разности расстояний между двумя ближайшими центрами кластеров, рассчитанных до очистки данных от аномалий и после неё.
В ответе запишите два числа: сначала , затем целую часть произведения .
Примечание. При расчёте расстояния до очистки три аномальные точки учитываются как отдельные одноточечные группы; после очистки используются только три основных кластера.
Для справки
Кинетическая энергия звезды массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех звезд:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/16x2XELKJWxG2ycVQqsqBYrbTTQZwzQP3/view
Фрагмент звездного неба спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию звезд по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух звезд каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его звезду, для которой сумма модулей разности кинетических энергий со всеми остальными звездами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе передачи данных датчики фиксируют помехи, из-за чего возникают аномалии — «лишние» точки, не относящиеся ни к одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одной звезде: координаты и , проекции вектора скорости и , а также масса .
Значения даны в одинаковых для всех звезд единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 10000.
Известно, что все описанные в файле звёзды (за исключением аномальных) подразделяются ровно на 4 кластера () с для каждого, а также в файле содержится ровно 5 аномальные точки. Гарантируется, что во всех кластерах количество точек различно.
Для каждого кластера определите его центр, затем найдите два числа: – количество звезд в кластере с наименьшей суммой координат и своего центра, у которых абсцисса больше абсциссы центра этого кластера, и – наименьшее евклидово расстояние между центрами четырех основных кластеров, рассчитанными после очистки данных от аномалий.
В ответе запишите два числа: сначала , затем целую часть произведения .
Для справки
Кинетическая энергия звезды массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех звезд:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1-PavigceCMDdWGVrc3njjbw1Da44E1KJ/view
Фрагмент звездного неба спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию звезд по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух звезд каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его звезду, для которой сумма модулей разности кинетических энергий со всеми остальными звездами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе передачи данных датчики фиксируют помехи, из-за чего возникают аномалии — «лишние» точки, не относящиеся ни к одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одной звезде: координаты и , проекции вектора скорости и , а также масса .
Значения даны в одинаковых для всех звезд единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 50000.
Известно, что все описанные в файле звёзды (за исключением аномальных) подразделяются ровно на 10 кластера () с для каждого, а также в файле содержится до 10 аномальные точки. Гарантируется, что во всех кластерах количество точек различно.
Для каждого кластера определите его центр, затем найдите два числа: – среднее арифметическое количество точек, находящихся внутри круга радиуса 2,0 с центром в центре своего кластера, для трёх наиболее удалённых от начала координат кластеров, округлённое до ближайшего целого числа, и – сумму расстояний между центрами всех возможных уникальных пар кластеров.
В ответе запишите два числа: сначала , затем целую часть произведения .
Для справки
Кинетическая энергия звезды массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех звезд:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1_Jti00awiT5hL7ZchaiQA7GC-xbY7_9N/view
Фрагмент звездного неба спроецирован на плоскость с декартовой системой координат. Ученый решил провести кластеризацию звезд по значениям их кинетической энергии, то есть разбить их множество на непересекающихся непустых подмножеств (кластеров), таких что модуль разности кинетических энергий любых двух звезд каждого подмножества не превосходит значения . Гарантируется, что такое разбиение существует и единственно для заданного .
Будем называть центром кластера такую его звезду, для которой сумма модулей разности кинетических энергий со всеми остальными звездами этого кластера минимальна. Для каждого кластера гарантируется единственность его центра.
В процессе передачи данных датчики фиксируют помехи, из-за чего возникают аномалии — «лишние» точки, не относящиеся ни к одному из кластеров. Эти аномальные точки необходимо отфильтровать и исключить из расчётов.
В каждой строке текстового файла хранится информация об одной звезде: координаты и , проекции вектора скорости и , а также масса .
Значения даны в одинаковых для всех звезд единицах измерения, обозначения единиц измерения в файле не приводятся.
Значения в строке разделяются одним или несколькими пробелами и/или символами табуляции. Количество строк в файле не превышает 50000.
Известно, что все описанные в файле звёзды (за исключением аномальных) подразделяются ровно на 10 кластера () с для каждого, а также в файле содержится до 10 аномальные точки. Гарантируется, что во всех кластерах количество точек различно.
Для каждого кластера определите его центр, затем найдите два числа: – суммарное количество точек во всех 10 кластерах, у которых одновременно абсцисса меньше абсциссы центра своего кластера, а ордината больше ординаты центра своего кластера, и – минимальное расстояние между центром наименьшего по количеству точек кластера и центром любого из остальных 9 кластеров.
В ответе запишите два числа: сначала целое число , затем целую часть произведения .
Для справки
Кинетическая энергия звезды массы , обладающего скоростью вычисляется по формуле:
.
Евклидово расстояние между двумя точками на плоскости и вычисляется по формуле:
.
Типовой пример организации данных во входном файле
Три строки файла для трех звезд:
0,67 -2,14 3,0 -4,0 0,2
3,14 7,22 3,2 4,3 0,7
1,33 5,56 0,0 5,22 0,456
Типовой пример имеет иллюстративный характер. Для выполнения задания используйте данные из прилагаемого файла.
Файл к заданию: https://drive.google.com/file/d/1uGRtYoaBCGk_PnNbMogMP20vGlh223h-/view
Когда будет экзамен
ИЮНЬ 2027
Дата сдачи 2027
18 ИЮНЯ
Резервные даты 2027
24 И 25 ИЮНЯ
Экзамен длится
3 Ч 55 МИН
Изучай средние баллы и оценивай свои шансы
Занимайся без стресса и паники и приходи к топовым результатам
В школе дают теорию, в Банке — вся нужная практика для экзамена
Готовься к экзаменам системно, а не «как получится»
Получай подсказки, если задача слишком сложная
Тренируйся по 10–15 минут каждый день
Отрабатывай западающие задания и темы
Тогда начинай тренироваться сегодня —
практика приведёт к высоким баллам